学術論文で報告されているアノマリーは本当にリターンが出る?
1. どんな論文?
学術誌が半世紀かけて公表してきた約 200 本の「アノマリー」を、実務家が実際に売買できる大きさの銘柄と、2006 年以降の市場に置き直して測り直した論文です。月次リターンの中央値は 0.48% から 0.07% へ落ち、上位に残った戦略も「運」を差し引くとほとんど消えました。新しい戦略も新しいデータも持ち込まず、測る条件を入れ替えるだけで有効性が失われてしまう悲しい現実を報告しています。
2. 同じ 200 本を、別の場所で測り直す
1973 年から 2016 年にかけて、株価を予測できると主張する論文が 200 本以上発表されてきました。多くの論文では、有望な銘柄群を買い・見込みの薄い銘柄群を売る組み方で月 0.5〜1.0% のリターンを報告しています。ところが同じ約 200 本を、機関投資家が現実に売買できる大きさの銘柄だけで、しかも 2006 年以降の市場で測り直すと、中央値は月 0.07% まで落ちます。どの銘柄で、どの時代に測ったのかを変えるだけで、アノマリーの有効性は大きく変わってしまうのです。
3. 論文の解説
この論文を書いたのは、米連邦準備制度理事会(Federal Reserve Board)の Andrew Y. Chen 氏と、UCLA の Ivo Welch 氏の 2 名です。中央銀行のエコノミストと、資産価格の研究者。学術界が積み上げてきたアノマリー群を、実務の目線で棚卸しすることを目的にしています。
どんな問いを立てたのか
株取引におけるアノマリーとは、「この特徴を持つ株は平均的に値上がりしやすい」というような株価の規則性のことです。モメンタム(直近上がった銘柄が上がり続けやすい傾向)、バリュー(割安な株ほど報われる、という規則性)、収益性、アクルーアル(会計上の利益と実際の現金の出入りのズレ)といった指標で検証し、報告された成績はしっかりした t 値を伴っています。統計的には文句のつけようがありません。
しかしながら、論文の検証環境は投資家が実際に売買する環境とは限りません。著者らが指摘するのは、以下に示す2種類のずれです。
- 対象銘柄のずれ : 論文の多くは CRSP(米国株の標準的な株価データベース)に載る全銘柄を使い、小さく売買しにくい数千の銘柄を含む
- 時代のずれ : サンプル期間の多くは 1980 年より前に始まり、2006 年よりかなり前で終わっている
先行研究がこの 2 つを別々に対処していたことも、著者らが壁と感じた点です。Chen and Zimmermann (2022) は流動性のふるいを掛けると期間内リターンが約 30% 減ることを示しましたが、2005 年以降までは見ていません。Chen and Velikov (2023) は取引コストと公表後減衰(手法が知れ渡るとリターンが下がる現象)を差し引くと期待リターンが実質ゼロになると示しましたが、対象銘柄を大型株には絞っていません。
対象銘柄を入れ替える —— 2 つのフィルター
そこで著者らは、同じアノマリー・同じ計算式のまま、対象銘柄のフィルタを毎月かけなおす実験を提案しました。使うフィルターは 2 種類です。
- ランク フィルタ : 時価総額の大きい順に上位 N 銘柄だけを残す(銘柄数に上限をかける)
- パーセンテージ フィルタ : 大きい順に足していき、市場全体の時価総額の上位 X% に達するまでを残す
この 2 つを利用して設定を作成します。本命は「Standard (N3000, 90%)」——上位 3,000 銘柄かつ時価総額上位 90% の両方を満たす銘柄で、大型で流動的なベースラインにあたります。もっと厳しい「Tight (N1000, 80%)」は Russell 1000(米国の大型株指数)や典型的な大型株ファクターに近い設定です。銘柄を除外するのではなく毎月フィルタリングして組み直すため、「実務家がその月に実際に取れたポジション」により近づきます。
ふるいを掛けると壊れるシグナルへの対処も必要です。例えば、空売り残高の上位 1% だけを使うようなシグナルは、流動性で絞った途端に中身が数銘柄になってしまいます。そこで著者らは、買い側か売り側が 20 銘柄に満たない月を「組めなかった月」と定義しました。そのような月が 1986〜2005 年の期間で 5% を超えるシグナルは丸ごと除外し、残ったシグナルについても、組めなかった月は取引を見送ったとみなして翌月のリターンをゼロにしています。除外の判断材料を 2005 年までに限ることで、未来を見て銘柄を選ぶ不正を回避しています。
t 値の分散から運を差し引く
論文のもう 1 つの核が、選択バイアスの扱いです。200 本の中から成績上位を取り出すと、「本当に強い手法」と「運が良かっただけの手法」が混在します。個別の t 値を見ても、両者は区別がつきません。
そこで著者らは、200 本を横に並べたときの t 値の分散 Var(t)(成績のばらつきの大きさ)に着目しました。論文自身の言い方を借りれば、「ダーツを投げる 200 匹の猿」です。t 値は平均リターンを、その測定のブレ幅で割った値なので、手法どうしの実力に差がまったく無ければ、Var(t) はいつでもちょうど 1.00 になります。この 1.00 が基準線で、観測された分散のうち基準線までは運が作った分、基準線を超えた分だけが手法どうしの実力差にあたります。そこで t 値に、分散のうち実力で説明できる割合を表す (Var(t) − 1) / Var(t) を掛け、調整後の t 値を計算しました。多数の候補から選んだ成績を、全体のばらつきに応じて割り引くこの操作を経験ベイズ収縮と呼びます。
ここで、上記は「アノマリーどうしが独立である」という非常に強い仮定を置いていることには注意が必要です。
測り直した結果、月 48bp が月 7bp へ
論文内では、提案手法に基づき 約 200 本の論文の追検証を行っています。素材は Chen and Zimmermann (2022) が公開しているオープンソースのデータセットで、公表済みのクロスセクション予測子をほぼすべて標準化されたコードで再現したものです。対象は CRSP 上場の米国株、ポートフォリオは毎月末に組み直す標準的な形。メインの設定は実務家の現実に最も近い Standard (N3000, 90%) で、前述のフィルタリング適用後に残った 170 本のアノマリーを対象としています。これを、各論文のサンプル期間で全銘柄を回したときの成績(=各論文が報告した値)と突き合わせます。
評価は月次のロング・ショート リターンに加えて、CAPM アルファ(市場全体の動きで説明できる分を差し引いた後に残る超過分)、年率シャープレシオ(リターンをブレの大きさで割った効率の指標)、プラスを保ったアノマリーの比率で行います。加えて、空売りを併用しない投資家のために Long − Mkt(買い持ちした側の成績から市場平均を引いた分)も測定します。
以下、金額の単位に bp(ベーシス ポイント。1bp = 0.01%)を使います。月 7bp は月 0.07%、年率にしておよそ 1% です。
月次リターンの中央値は以下の通りです。
| 対象銘柄 | 2005 年まで | 2006 年以降 |
|---|---|---|
| 全銘柄 | 48bp | 19bp |
| 大型株(時価総額上位 90%) | 26bp | 7bp |
期間だけを動かせば約 60% 減、銘柄を大型株に限定すれば約 50% 減、両方の影響を合わせればおよそ 85% のリターンが失われます。
さらに厳しい検証も続きます。Var(t) は 1.09 と基準線の 1.00 にほぼ一致し、実力で説明できる割合は約 8%。最良のアノマリー(キャッシュベース営業収益性)ですら元のリターン 66bp が調整後 6bp に、Long − Mkt は Var(t) が 0.98 と基準線を下回り、調整後は全アノマリーがぴったり 0.00 になります。リターンが残ったのは収益性だけ(中央値 0.24% / 月)で、モメンタムは 0.05%、バリューは −0.04% でした。
取引コストも大きな問題です。値幅(ビッド・アスク スプレッド)が NYSE 中央値の約 4 倍の銘柄をオーバーウェイトし、毎月、買い側と売り側を合わせて約 40% を入れ替えるため、往復は月 20bp 近くのコストがかかります。平均したコストを差し引くと約 −1bp / 月、コストを最小化しても約 4bp / 月となります。
ただし著者らは、アノマリーが偽物だったとは言っていません。統計的には真の発見であり、「どの銘柄範囲か」「どの期間か」を問い直すべきだと述べています。
It is a reminder that statistical significance and economic implementability are different things.
統計的に有意であることと、それを実際の運用に落とせることは別物だ、という戒めです。
4. 思ったこと
- 実運用において非常に重要な研究: 本研究が示したような「公表後リターンの半減」「多数の候補から上位を選んだことによるバイアス」の存在は、個人投資家にとっても重要な示唆を与えてくれます。「どの銘柄範囲で測定されているか」「どの期間で測定されているか」を常に確認し、長期的なパフォーマンスを過信しない姿勢が求められます。
- t 値のばらつきに関する仮定はかなり強い: t 値のばらつきの補正で利用した提案理論では、アノマリーどうしが独立であることを前提にしています。収益性系のシグナル同士は似た情報を見ているはずなので、この仮定がきれいに成り立つとは考えづらいです。取引コストの数字も別研究からの持ち込みなので、そこは割り引いて読みたいところです。
- 買い側だけの成績も注目: 空売りを併用しない投資家にとっては、買い持ちした側から市場平均を引いた結果が非常に重要です。米国データではその調整後のリターンはほぼゼロでした。日本ではどうなのかも気になります。
5. 検証してみました
論文で行っているアノマリーの追検証を、私も日本の大型株でやってみました。論文の主張の 2 本の柱(大型株・現代ではリターンが消える/ 上位の成績はほぼ運)が、市場を替えても同じ形で立つのかをチェックします。
結果は、典型的な 1 本では論文の水準を下回ってゼロを割った一方、上位の成績を「ほぼ運」と言い切れるところまでは行きませんでした。代表的な 1 本、36 本の全体像、運の差し引きの順に見ていきます。
検査 1: 代表的な 1 本(12-1 モメンタム)を 18 年回した結果
代表的なアノマリーを 1 本だけ取り出し、教科書どおりに回したときの成績と、測る条件を変えると成績がどう動くのかをチェックします。
使うのは 12-1 モメンタム(直近 12 か月から直近 1 か月を除いた騰落率)1 本だけです。毎月末に 224 社をそのアノマリーが高い順に並べ、上位 5 分の 1 の 44 社を同じ金額ずつ買い、下位 5 分の 1 を同じ金額ずつ売るロング・ショートを組みます。使用するのは月末終値までの情報だけで、実際に建てる際にはその翌営業日の終値を利用します。
この組み方を、データが取れる 226 か月分通しで積み上げた結果が次の図です。
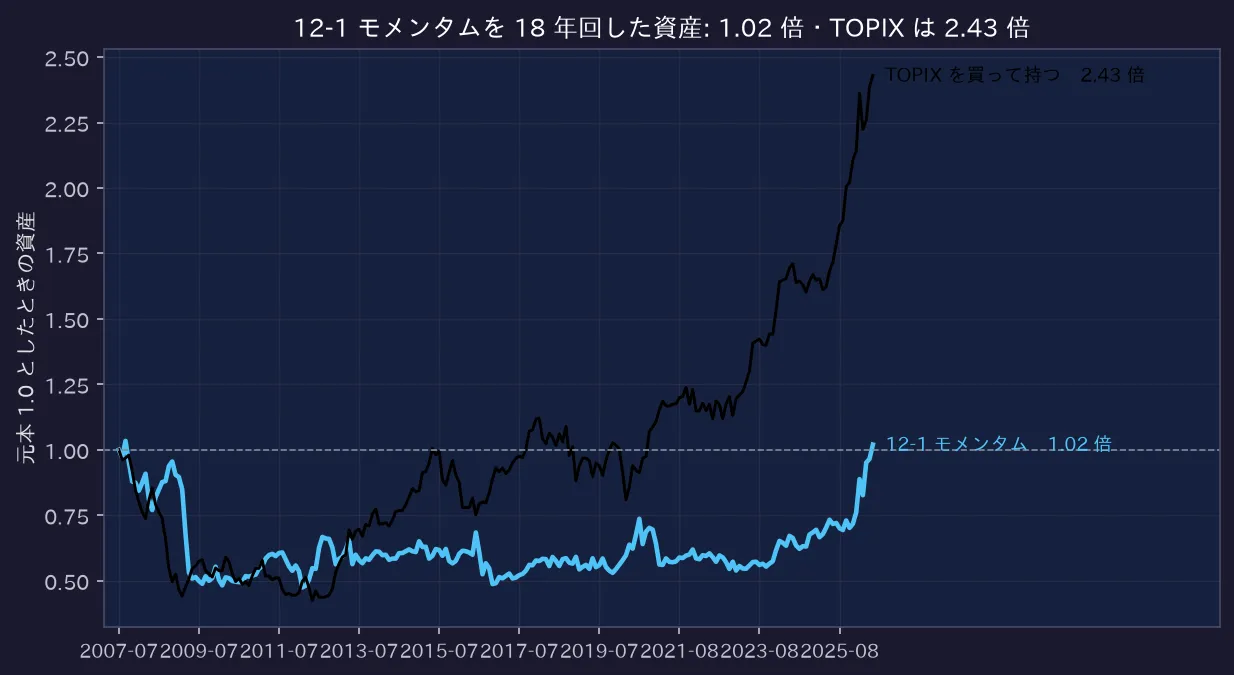
2007-07〜2026-05 の 226 か月を、同じ元本から積み上げた図。12-1 モメンタムは買い 1 単位 + 売り 1 単位、TOPIX は買い 1 単位なので、水準を直に比べるのではなく増え方の向きを見てください。
資産は 1.02 倍にしかなりませんでした。同じ期間に TOPIX を買って持っていれば 2.43 倍です。
では、測る条件を替えるとどうなるか。論文と同様の 2×2(全銘柄 / 大型株 × 2005 年まで / 2006 年以降)通りの実験は、手元のデータが大型株・2006 年以降しかないので直接は行えません。そこで、期間(前半 / 後半)と売買のしやすさ(全 224 社 / 売買代金上位 50%)で 4 パターンを定義し、測る条件を変えながら 4 回実験を繰り返しました。売買代金の上位半分を残す絞り方は、§3 の ランク フィルタ を時価総額ではなく売買代金で引いたものに相当します。
| 条件 | 期間 | 月数 | 平均リターン | t 値 | 片側の社数 | 同じ期間の TOPIX |
|---|---|---|---|---|---|---|
| 全体 | 2013-07-31〜2026-05-29 | 154 か月 | +0.48% | 1.27 | 43 社 | +0.91% |
| 前半 × 全 224 社 | 2013-07-31〜2019-11-29 | 77 か月 | +0.02% | 0.04 | 43 社 | +0.60% |
| 後半 × 全 224 社 | 2019-12-30〜2026-05-29 | 77 か月 | +0.94% | 1.68 | 44 社 | +1.22% |
| 前半 × 売買代金上位 50% | 2013-07-31〜2019-11-29 | 77 か月 | -0.12% | -0.24 | 21 社 | +0.60% |
| 後半 × 売買代金上位 50% | 2019-12-30〜2026-05-29 | 77 か月 | +1.76% | 2.54 | 22 社 | +1.22% |
同じシグナル・同じ計算式・同じ売買ルールのまま、対象にする月と銘柄を替えるだけで、リターンは -0.12% / 月(前半 × 売買代金上位 50%)から +1.76% / 月(後半 × 売買代金上位 50%)まで開きました。どの銘柄で、どの時代に測ったのかが、この 1 本のアノマリーの成績をかなり左右していると読み取れます。ただし日本では後半のほうが良く、論文が米国で見た「現代ほど悪い」とは向きが逆でした。また売買代金で絞ると片側が 43 社から 21 社まで減るので、絞った側の 2 マスは測り方も粗くなっています。
検査 2: 36 本のアノマリーで検証
価格と出来高だけで組める代表的な手法を 36 種類用意し、検査 1 と同様の実験を行いました。
| 指標 | 論文 米国・2005 年以降 | 本検証 全 224 社 | 本検証 売買代金上位 50% |
|---|---|---|---|
| 平均 | +0.08% | -0.08% | -0.06% |
| 中央値 | +0.07% | -0.04% | +0.07% |
| 第 1 四分位数(下位 25%) | -0.04% | -0.40% | -0.67% |
| 第 3 四分位数(上位 25%) | +0.18% | +0.22% | +0.43% |
| プラスだった手法 | 67% | 44.4% | 58.3% |
| t 値の中央値 | 0.45 | -0.21 | 0.19 |
| 年率シャープレシオの中央値 | 0.11 | -0.05 | 0.04 |
| CAPM アルファの中央値 | +0.09% | -0.01% | +0.13% |
| CAPM アルファの t 値の中央値 | 0.64 | -0.05 | 0.41 |
| 本数 | 170 | 36 | 36 |
| 1 本あたり月数(平均) | — | 226 か月 | 214 か月 |
論文が米国の大型株で見た中央値 +0.07% / 月に対し、日本の大型株では -0.04% / 月。CAPM アルファでも +0.09% に対し -0.01% で、典型的な 1 本のリターンは論文より下、しかも符号まで逆になりました。プラスだったのは 44.4% (16/36)、平均リターンがゼロと統計的に区別できなかったものが 72.2% (26/36) でした。
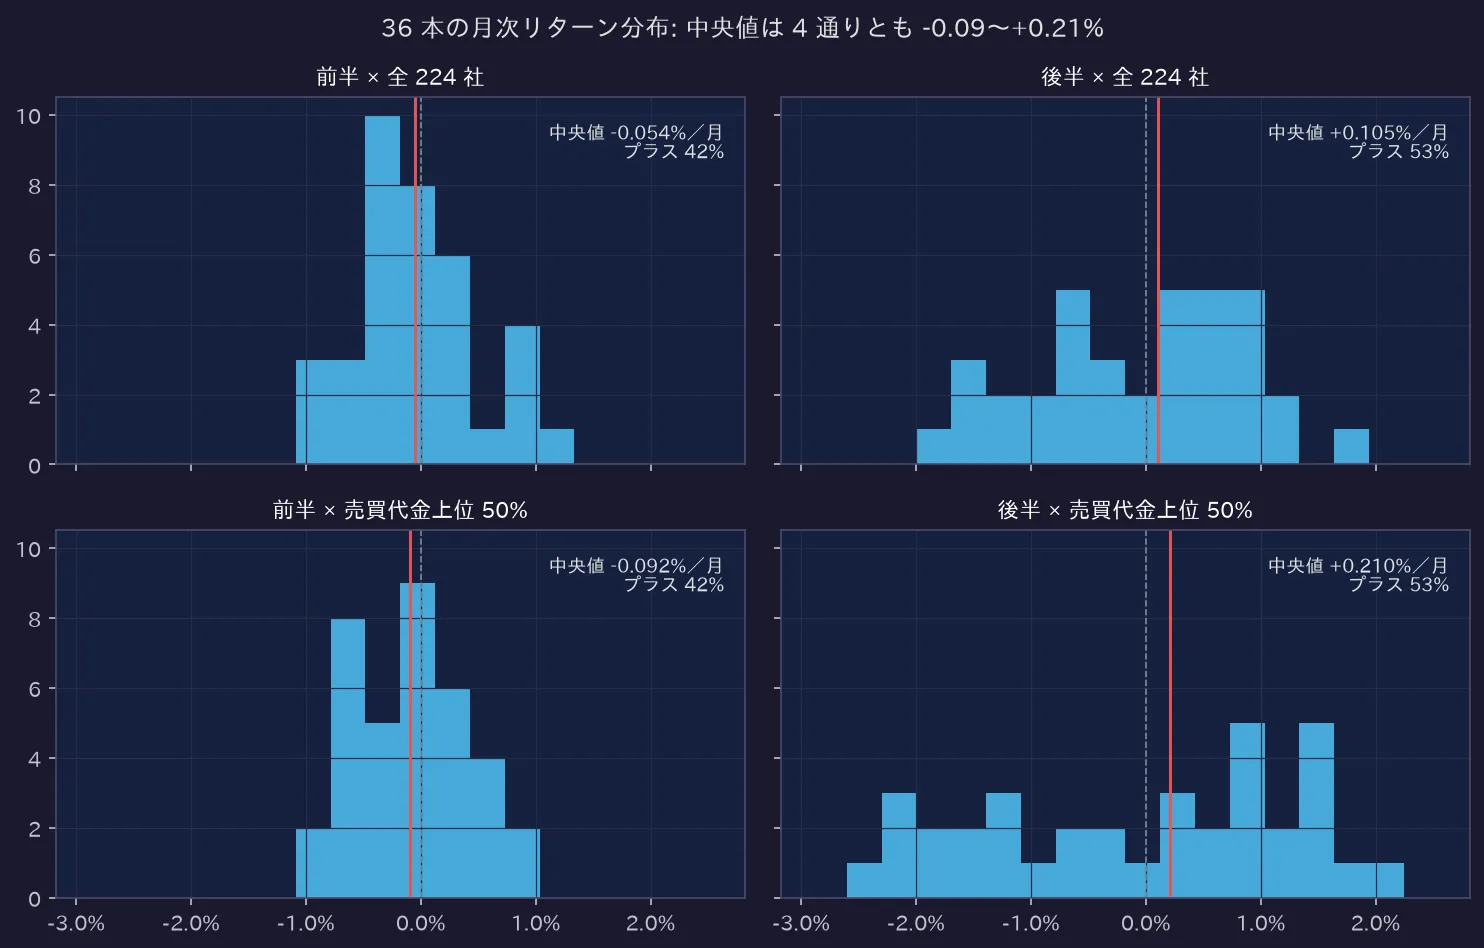
期間(前半・後半)と売買のしやすさ(全 224 社・売買代金上位 50%)で 4 通りに分割し、各 36 本のアノマリーの中央値を並べた図。赤い縦線が中央値、灰の破線がゼロで、4 通りとも同じ横軸です。
検査 1 と同様の 2 軸を 36 本すべてに適用すると、中央値は 4 通りとも -0.09%〜+0.21% の範囲に収まりました。また、中央値の符号は期間(前半・後半)で反転しています。
| 条件 | 期間 | 1 本あたり月数 | 中央値 | プラスだった手法 |
|---|---|---|---|---|
| 前半 × 全 224 社 | 2013-07-31〜2019-11-29 | 77 か月 | -0.05% | 41.7% |
| 後半 × 全 224 社 | 2019-12-30〜2026-05-29 | 77 か月 | +0.10% | 52.8% |
| 前半 × 売買代金上位 50% | 2013-07-31〜2019-11-29 | 75 か月 | -0.09% | 41.7% |
| 後半 × 売買代金上位 50% | 2019-12-30〜2026-05-29 | 77 か月 | +0.21% | 52.8% |
念のため、全 224 社と売買代金上位 50% で期間を揃えた比較も行いましたが、以下のように乖離は半分程度に縮小するものの、傾向は変わりませんでした。
| 売買できる範囲 | 中央値 | CAPM アルファの中央値 | 片側の社数 |
|---|---|---|---|
| 全 224 社 | +0.01% | +0.02% | 42 社 |
| 売買代金上位 50% | +0.07% | +0.13% | 21 社 |
次に、36 本をアノマリーの分類でまとめます。
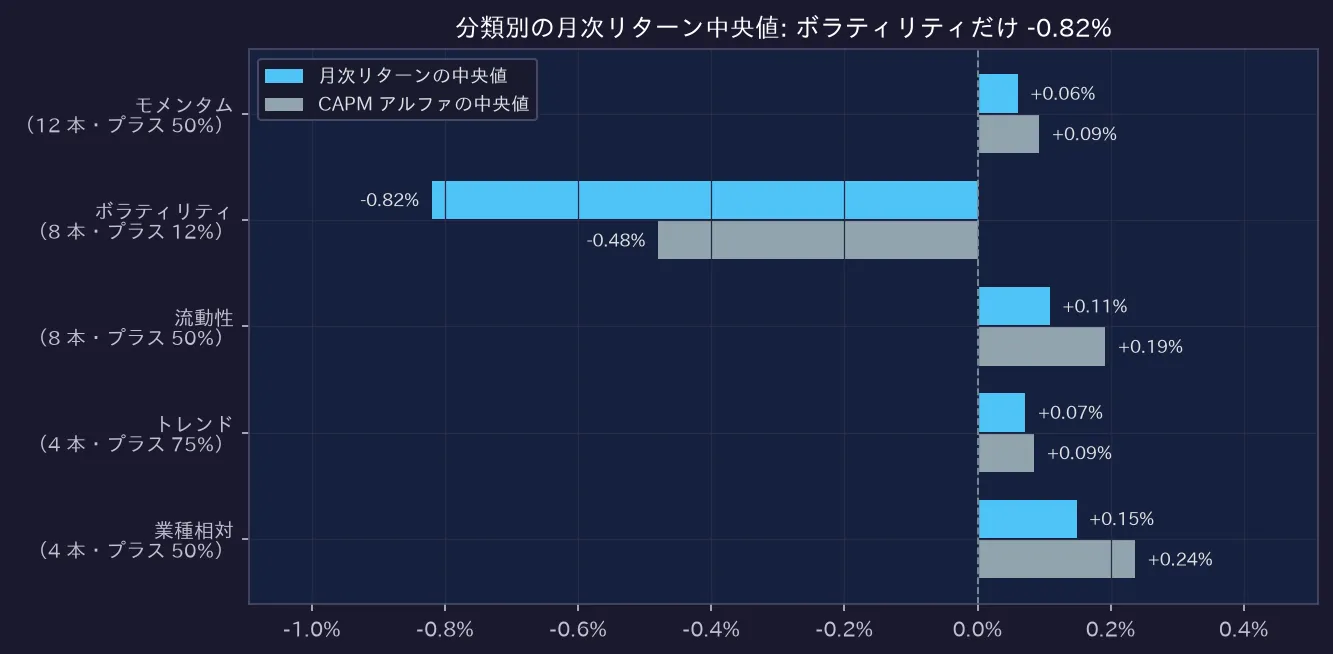
5 つの分類ごとに、月次リターンの中央値(水色)と CAPM アルファの中央値(灰色)を並べた図。分類名の下に、本数とプラスだった手法の割合が記載されています。各手法が組めた月すべて・全 224 社で測っています。
値動きの大きさを使うボラティリティの分類だけが中央値 -0.82% / 月と沈み、プラスは 8 本中 1 本でした。値動きの小さい銘柄を買い、大きい銘柄を売るという組み方が、市場の上昇局面では不利に働くことと関連していそうです。
検査 3: 運を差し引く
§3 の経験ベイズ収縮が土台にしている診断を、そのまま 36 本に当てはめます。t 値の分散 Var(t) の 90% 信頼区間が基準線 1.00 を含めば成績の差はほぼ運、含まなければ「実力がある」と解釈します。
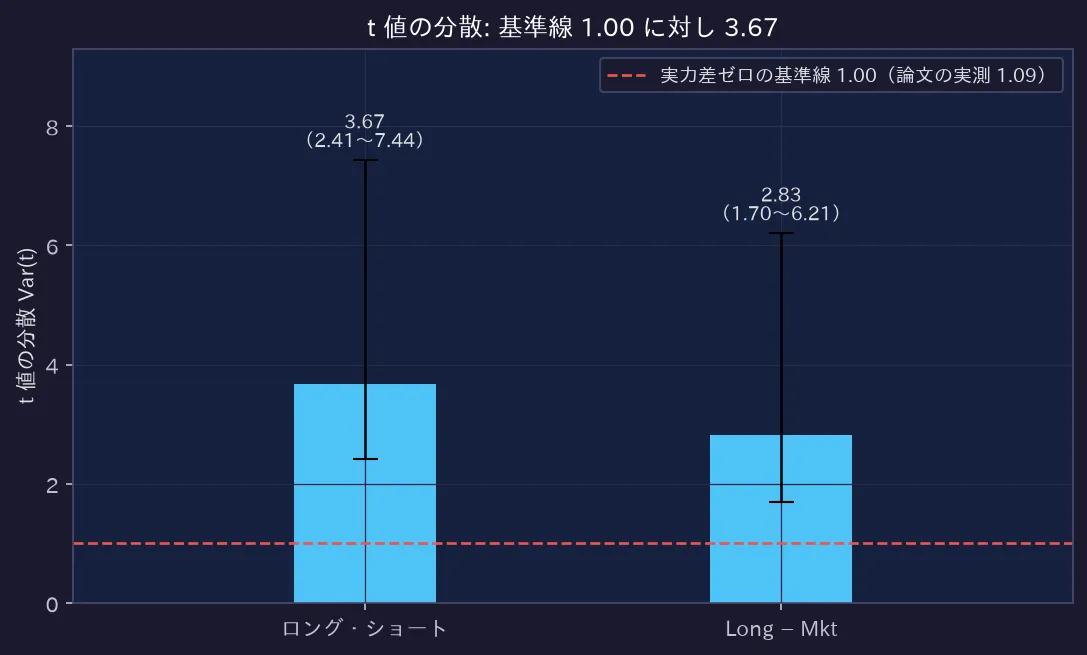
棒が赤い破線の 1.00 を超えた分が、運を差し引いた実力にあたります。誤差線は、36 本が同時に組めた月を元に計算した 90% 信頼区間です。
| 測った量 | 分散 Var(t) | 90% 信頼区間 | 基準線 1.00 を含むか |
|---|---|---|---|
| ロング・ショート(買い − 売り) | 3.67 | 2.41〜7.44 | 含まない |
| Long − Mkt(買い側 − TOPIX) | 2.83 | 1.70〜6.21 | 含まない |
どちらの信頼区間も基準線をまたぎません。論文が米国で得た 1.09(基準線とほぼ同じ)とは違い、日本の大型株では「36 本の成績差はほぼ運」という結論にはなりませんでした。
なお、この検査は決算の数字を利用しておらず、論文で唯一有効性が確認された収益性に関するアノマリーを追検証できていません。また、対象も現在まで残っている 224 社に限られ、生存者バイアスが効いている可能性は排除できません。
6. まとめ
- やったこと: 論文が米国の大型株で行った測り直しを、日本の大型株 224 社と価格・出来高で組める 36 本のシグナルに置き換え追検証しました。
- 分かったこと: 測る条件で結果が変わるという論文の骨格は日本でも成り立ちました。一方で、「成績差はほぼ運によるものだ」という結論にはなりませんでした。
- これから気になること: 今回は限られた利用データでの検証にとどまっており、決算を中心としたより発展的な分析も行いたいです。